-
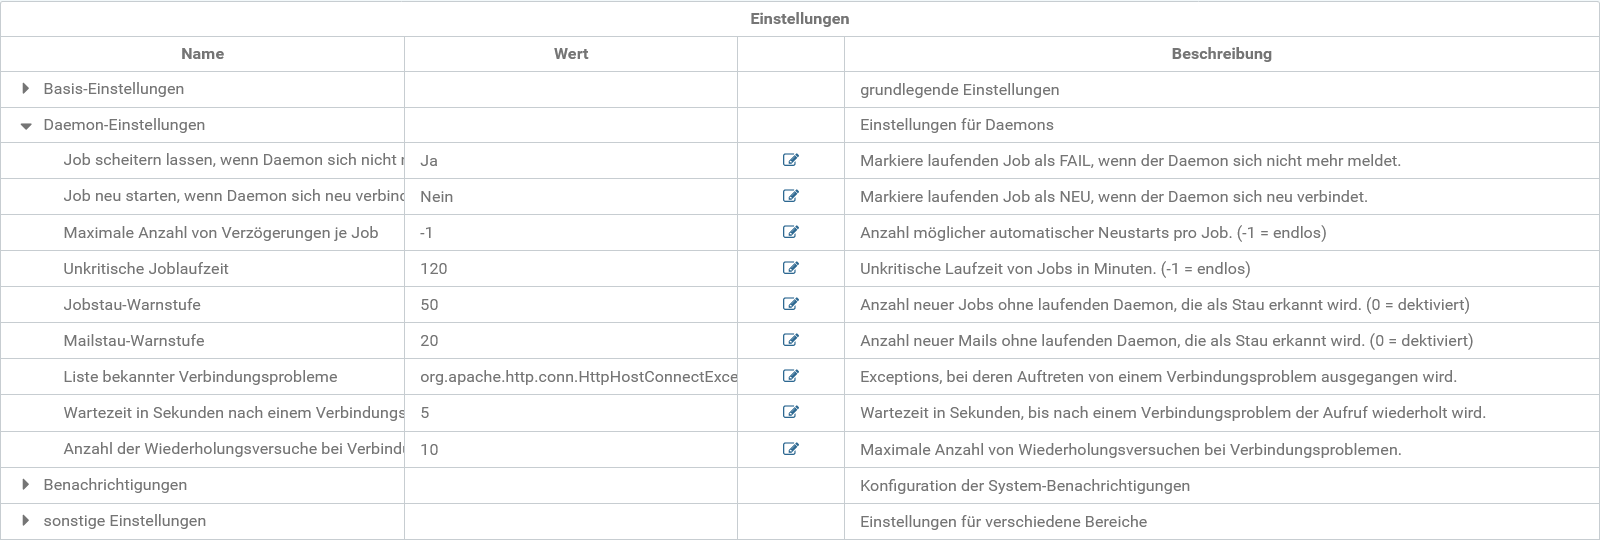
Job scheitern lassen, wenn Daemon sich nicht mehr meldet: Wenn "ja" eingestellt ist, werden Jobs vom Scheduler als fehlgeschlagen (FAIL) markiert, wenn der Lebenszyklus des bearbeitenden Daemons in ein Timeout läuft.
-
Job neu starten, wenn Daemon sich neu verbindet: Wenn "ja" eingestellt ist, werden laufende Jobs auf "NEW" gestellt, wenn der bearbeitende Daemon sich neu verbindet.
-
Maximal Anzahl von Verzögerungen je Job: Bei einer Zahl > -1 wird die Anzahl automatischer Neustarts pro Job limitiert.
-
2.2.2+: Unkritische Joblaufzeit: Bei Werten > -1 wird auf der Oberfläche und evtl. per Mail gewarnt, wenn Jobs länger als die angegebene Zeit in Minuten laufen.
-
2.2.2+: Jobstau-Warnstufe: Bei Werten > 0 wird auf der Oberfläche und evtl. per Mail gewarnt, wenn die Anzahle neuer Jobs ohne laufenden Daemon für einen Cluster den angegebenen Wert übersteigt.
-
2.2.2+: Mailstau-Warnstufe: Bei Werten > 0 wird auf der Oberfläche gewarnt, wenn die Anzahle neuer Mails ohne laufenden Daemon den angegebenen Wert übersteigt.
-
Es wird auch gewarnt, wenn die Anzahl der Mails, die nicht verschickt werden konnten, den angegebenen Wert übersteigt.
-
-
Liste bekannter Verbindungsprobleme: Exceptions, bei deren Auftreten von einem Verbindungsproblem ausgegangen wird. Details siehe hier.
-
Wartezeit in Sekunden nach einem Verbindungsproblem: Wartezeit in Sekunden, bis nach einem Verbindungsproblem der Aufruf wiederholt wird.
-
Anzahl der Wiederholungsversuche bei Verbindungsproblemen: Maximale Anzahl von Wiederholungsversuchen bei Verbindungsproblemen.